Kurz gesagt
Eine Wissensdatenbank bauen Sie in sechs Schritten auf: Quellen festlegen, Rechte und Zugriffe klären, Dokumente aufbereiten, mit echten Fragen testen, einführen und dauerhaft pflegen. Für die Technik gibt es drei Wege: fertige Software, ein selbst betriebenes System oder eine Lösung, die ein Dienstleister baut. Datenschutzrechtlich prüfen Sie vor allem Art. 28 und Art. 35 DSGVO.
Wissensdatenbank aufbauen: Was gehört dazu?
Wer eine Wissensdatenbank aufbauen will, sammelt Handbücher, Richtlinien, Protokolle und Antworten auf wiederkehrende Fragen an einem Ort und macht sie durchsuchbar. Klassisch geschieht das in einem Wiki oder einer Knowledge Base. Mit KI kommt eine zweite Ebene hinzu: Beschäftigte stellen eine Frage in eigenen Worten und erhalten eine Antwort mit Verweis auf die Fundstelle.
Technisch steckt dahinter meist Retrieval Augmented Generation, kurz RAG. Lewis und Kollegen beschrieben das Verfahren 2020 als Kombination aus einem vortrainierten Sprachmodell und einem durchsuchbaren Textindex. Die Datenschutzkonferenz (DSK) nennt in ihrer Orientierungshilfe von Oktober 2025 vier Kernbausteine: Retriever, Embedding-Modell, Vektordatenbank und generatives Sprachmodell.
Der Ablauf ist immer ähnlich. Dokumente werden in kurze Abschnitte zerlegt, in Vektoren umgerechnet und gespeichert. Bei einer Frage sucht das System die inhaltlich passendsten Abschnitte und gibt sie dem Sprachmodell als Grundlage für die Antwort mit. Wie eine solche KI-Wissensdatenbank im Alltag aussieht, zeigt die Startseite.
Der Vorteil gegenüber einem reinen Chatbot: Das Wissen steckt in Ihren Dokumenten, nicht im Modell. Laut DSK lassen sich Einträge in der Datenbank deshalb einfach aktualisieren, löschen und beauskunften. Das Training des Sprachmodells selbst bleibt davon unberührt.
Welche drei Wege gibt es?
Bevor Sie Inhalte sammeln, entscheiden Sie, wo die Wissensdatenbank laufen soll. Die Wahl bestimmt, wer Zugriff auf die Daten hat, welche Verträge nötig sind und wie viel eigenes Wissen Ihr Team braucht.
Fertige Software nutzt vorhandene Plattformen. Ein Beispiel ist Microsoft 365 Copilot: Laut Microsoft zeigt Copilot nur Unternehmensdaten an, für die eine Person mindestens Leserechte hat, und Prompts sowie Antworten werden nicht zum Training der Basismodelle verwendet. Einen Überblick über solche Werkzeuge gibt die Seite zu Wissensdatenbank-Software.
Selbst betreiben heißt: Sprachmodell, Datenbank und Oberfläche laufen auf eigener Hardware, etwa mit Ollama und Open WebUI. Die DSK hält fest, dass ein RAG-System so unter Umständen on-premise betrieben werden kann und personenbezogene Daten dann nicht an Online-Betreiber großer Sprachmodelle gehen. Die Anleitung dazu steht auf der Seite zur lokalen KI.
Bauen lassen bedeutet, dass ein Dienstleister die Lösung nach Ihren Anforderungen entwickelt und oft auch betreibt. Verarbeitet er dabei personenbezogene Daten in Ihrem Auftrag, brauchen Sie einen Vertrag nach Art. 28 DSGVO. Was die Wege im Betrieb kosten, vergleicht die Seite zu den Kosten einer KI-Wissensdatenbank.
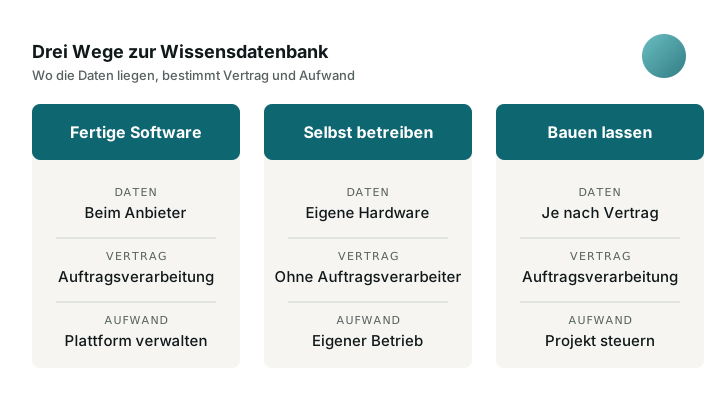
| Kriterium | Fertige Software | Selbst betreiben | Bauen lassen |
|---|---|---|---|
| Ort der Daten | Beim Anbieter, je nach Vertrag und Region | Eigene Server oder eigenes Rechenzentrum | Je nach Vereinbarung beim Dienstleister oder bei Ihnen |
| Start | Schnell, wenn die Plattform schon im Haus ist | Hardware, Installation und Einrichtung nötig | Projekt mit Anforderungen, Umsetzung und Abnahme |
| Anpassbarkeit | Im Rahmen der Produktfunktionen | Hoch, Modelle und Einstellungen frei wählbar | Hoch, nach Pflichtenheft |
| Eigenes Know-how | Administration der Plattform | Betrieb, Updates und Sicherheit im eigenen Team | Steuerung des Dienstleisters und Abnahme |
| DSGVO-Vertrag | In der Regel Auftragsverarbeitung mit dem Anbieter | Kein Auftragsverarbeiter für den Kern nötig | Auftragsverarbeitung, wenn der Dienstleister Daten verarbeitet |
In sechs Schritten zur Wissensdatenbank
Unabhängig vom Weg folgt der Aufbau denselben Schritten. Planen Sie die Reihenfolge ernst: Fehler bei Quellen und Rechten lassen sich später nur mühsam beheben, weil das System sie in jede Antwort trägt.
Quellen festlegen
Bestimmen Sie, welche Fragen die Wissensdatenbank beantworten soll und welche Dokumente dafür verbindlich sind.
Rechte und Zugriffe klären
Prüfen Sie, wer welche Inhalte sehen darf, und übertragen Sie diese Regeln in die Datenbank.
Dokumente aufbereiten
Bereinigen Sie Formate, entfernen Sie Dubletten und Veraltetes, und zerlegen Sie Texte in sinnvolle Abschnitte.
Mit echten Fragen testen
Stellen Sie typische Fragen aus dem Alltag und vergleichen Sie jede Antwort mit der Fundstelle.
Einführen
Starten Sie mit einer Abteilung, legen Sie Nutzungsregeln fest und schulen Sie die ersten Anwender.
Pflegen
Benennen Sie Verantwortliche je Bereich, die Inhalte aktuell halten und veraltete Dokumente entfernen.
Welche Quellen gehören in die Wissensdatenbank?
Am Anfang stehen die Fragen. Sammeln Sie zehn bis zwanzig Fragen, die im Service, in der Technik oder im Vertrieb ständig gestellt werden, etwa bei einem Maschinenbauer mit Servicehandbüchern: Welches Ersatzteil passt zu Baureihe X? Danach suchen Sie die Dokumente, die diese Fragen verbindlich beantworten.
Die Qualität der Quellen bestimmt die Qualität der Antworten. Die DSK schreibt, dass die Zuverlässigkeit von RAG-Systemen stark von Qualität, Aktualität und Vollständigkeit der Referenzdokumente abhängt. Dokumente aus unbekannten oder nicht vertrauenswürdigen Quellen sollten laut DSK nicht verwendet werden.
Vorsicht bei externen Quellen: Bindet ein System Dokumente Dritter oder eine Websuche ein, müssen Rechtmäßigkeit, Eignung und Richtigkeit geprüft sein. Diese Anforderungen werden nach Einschätzung der DSK bei einer Websuche regelmäßig nicht erfüllt.
Häufige Quellen sind eine bestehende Knowledge Base aus Support oder Fachabteilung und ein Firmenwiki. Beide bringen Struktur und Verantwortliche mit und eignen sich deshalb gut als erster Bestand.
- Verbindlich: nur freigegebene Fassungen, keine Entwürfe oder privaten Notizen.
- Aktuell: jedes Dokument hat ein Datum und eine verantwortliche Person.
- Eindeutig: pro Thema eine gültige Quelle, Dubletten vorher aussortieren.
- Sparsam: personenbezogene Daten nur aufnehmen, wenn die Antworten sie brauchen.
Wie klären Sie Rechte und Zugriffe?
Eine Wissensdatenbank macht Inhalte leichter auffindbar. Das gilt auch für Inhalte, die bisher nur versteckt lagen, weil Freigaben zu weit gefasst waren. Prüfen Sie deshalb vor dem Start, welche Ordner und Bereiche wirklich für wen gedacht sind.
Die DSK empfiehlt für RAG-Systeme bewährte Maßnahmen wie Mandantentrennung und ein Rechte- und Rollenkonzept für Bereiche der Vektordatenbank und die Referenzdokumente. Im Sprachmodell selbst lässt sich dagegen nicht steuern, wer welche Informationen sehen darf. Die Zugriffskontrolle muss also vor dem Modell greifen.
Fertige Software übernimmt meist die vorhandenen Berechtigungen. Microsoft weist bei Copilot ausdrücklich darauf hin, die Berechtigungsmodelle etwa in SharePoint zu nutzen, damit die richtigen Personen Zugriff auf die richtigen Inhalte haben. Zu weit gefasste Freigaben werden so direkt sichtbar.
Klären Sie außerdem die Nutzungsrechte an fremden Dokumenten. Gekaufte Normen, Fachdatenbanken oder Herstellerunterlagen unterliegen Lizenzbedingungen, die eine Verarbeitung in einem KI-System erlauben oder ausschließen können. Prüfen Sie diese Bedingungen vor dem Import.
Wie bereiten Sie Dokumente auf?
Aufbereitung ist der Schritt mit dem meisten Aufwand und der größten Wirkung. Die DSK rät, vor dem Zerlegen störende Elemente wie Kopf- und Fußzeilen oder Seitennummern zu entfernen und Dokumente in Fließtext zu überführen. Gescannte PDFs ohne Textebene brauchen vorher eine Texterkennung.
Danach werden Texte in Abschnitte zerlegt, das sogenannte Chunking. Größe und Überlappung der Abschnitte beeinflussen, was die Suche später findet. Laut DSK sollten einzelne Abschnitte möglichst abgeschlossene Sinneinheiten enthalten. Gleich lange Abschnitte nach fester Zeichenzahl können Zusammenhänge zerreißen.
Für die Umrechnung in Vektoren wählen Sie ein Embedding-Modell. Die DSK empfiehlt bei deutschsprachigen Dokumenten ein Modell, das mit deutschen Texten trainiert wurde, weil sonst weniger passende Abschnitte gefunden werden. Die Vektoren landen in einer Vektordatenbank.
Planen Sie Änderungen sorgfältig. Die Dokumentation von Open WebUI beschreibt, dass ein Wechsel des Embedding-Modells eine Neuindizierung aller Dokumente erfordert, weil Vektoren verschiedener Modelle nicht zueinander passen.
Wie testen Sie die Wissensdatenbank?
Testen Sie mit den Fragen aus dem ersten Schritt. Für jede Frage notieren Sie vorher die richtige Antwort und die Fundstelle. Dann prüfen Sie, ob das System die richtige Stelle findet und ob die Antwort sie korrekt wiedergibt. Open WebUI empfiehlt genau dieses Vorgehen: Antwort und Quellenangaben mit dem Originaldokument vergleichen.
Rechnen Sie mit Grenzen. Die DSK weist darauf hin, dass Sprachmodelle bei widersprüchlichen Inhalten dazu neigen können, Wissen aus ihren Trainingsdaten wiederzugeben. Als Gegenmaßnahme nennt sie einen Systemprompt, der das System anweist, nur mit den referenzierten Quellen zu antworten. Außerdem können logisch zusammengehörende Aussagen, die in verschiedenen Abschnitten stehen, unvollständig gefunden werden. Mehr zu erfundenen Antworten erklärt die Seite zu KI-Halluzinationen.
| Prüfpunkt | Frage an den Test |
|---|---|
| Trefferqualität | Findet die Suche den Abschnitt, in dem die Antwort steht? |
| Richtigkeit | Gibt die Antwort den Inhalt der Quelle korrekt wieder? |
| Quellenangabe | Nennt das System die Fundstelle, und lässt sie sich öffnen? |
| Nichtwissen | Sagt das System, dass es keine Antwort hat, wenn die Quelle fehlt? |
| Berechtigungen | Sieht eine Testperson ohne Zugriff wirklich keine gesperrten Inhalte? |
| Aktualität | Verschwindet eine gelöschte oder ersetzte Fassung aus den Antworten? |
Wie führen Sie die Wissensdatenbank ein und halten sie aktuell?
Führen Sie die Wissensdatenbank schrittweise ein, etwa zuerst im Service oder in einer Abteilung mit klar umrissenen Fragen. So sammeln Sie Rückmeldungen, bevor viele Menschen sich auf die Antworten verlassen.
Legen Sie Regeln fest. Die DSK empfiehlt, klar und dokumentiert zu regeln, ob, unter welchen Voraussetzungen und zu welchen Zwecken KI-Anwendungen genutzt werden dürfen. Sie nennt dafür eine Dienstanweisung oder eine Betriebsvereinbarung und weist darauf hin, dass die Einführung einer KI-Anwendung in einigen Fällen ein Mitbestimmungsrecht des Betriebsrats berührt.
Pflege ist eine Daueraufgabe. Laut DSK muss die verantwortliche Stelle regelmäßig prüfen, ob die Referenzdokumente aktuell und vollständig sind. Einträge in der Vektordatenbank sind direkt adressierbar und lassen sich gezielt löschen, sodass übliche Löschfristen auch hier greifen. Wie Sie Wissen dauerhaft im Unternehmen halten, beschreibt die Seite zum KI-Wissensmanagement.
Welche DSGVO-Pflichten gelten beim Aufbau?
Enthalten die Dokumente personenbezogene Daten, braucht die Verarbeitung eine Rechtsgrundlage. Die DSK betont, dass dies ausdrücklich auch für die Verarbeitung der Referenzdokumente und die Speicherung in der Vektordatenbank gilt.
Auftragsverarbeitung (Art. 28 DSGVO): Lässt ein Unternehmen Daten von einem Dienstleister verarbeiten, darf es nach Absatz 1 nur mit Auftragsverarbeitern arbeiten, die hinreichende Garantien für geeignete technische und organisatorische Maßnahmen bieten. Absatz 3 verlangt einen Vertrag, der unter anderem Gegenstand, Dauer, Art und Zweck der Verarbeitung festlegt. Nutzen Sie eine KI-Anwendung als Cloud-Lösung, liegt laut DSK häufig eine Auftragsverarbeitung vor. Betreiben Sie die Anwendung ausschließlich auf eigenen Servern zu eigenen Zwecken, sind Sie in der Regel allein verantwortlich.
Datenschutz-Folgenabschätzung (Art. 35 DSGVO): Hat eine Verarbeitung, insbesondere mit neuen Technologien, voraussichtlich ein hohes Risiko für die Rechte und Freiheiten von Personen, führt der Verantwortliche vorab eine Folgenabschätzung durch. Nach Absatz 7 enthält sie mindestens eine Beschreibung der Verarbeitung, eine Bewertung von Notwendigkeit und Verhältnismäßigkeit, eine Risikobewertung und die geplanten Abhilfemaßnahmen. Die DSK schreibt, dass beim Einsatz von KI-Anwendungen ein hohes Risiko vielfach vorliegen wird.
Achten Sie bei fertiger Software darauf, dass der Anbieter genug Informationen zur Funktionsweise liefert. Ohne sie lässt sich die Folgenabschätzung laut DSK kaum erstellen. Datenschutzrechtlich vorzugswürdig sind nach der DSK Anwendungen, die Ein- und Ausgaben nicht zum Training verwenden. Mehr zum Datenschutz bei KI-Werkzeugen erklärt die Seite zum KI-Datenschutz.
Diese Seite erklärt die Rechtslage allgemein und ersetzt keine Rechtsberatung. Ob eine Folgenabschätzung nötig ist und welche Rechtsgrundlage greift, klären Sie mit Ihrer Datenschutzbeauftragten oder Ihrem Datenschutzbeauftragten.
Checkliste für den Start
Mit diesen Punkten können Sie den Aufbau in der nächsten Woche beginnen. Jeder Punkt lässt sich ohne Technikentscheidung erledigen und spart später Nacharbeit.
Möchten Sie die Punkte mit Ihrem Team durchgehen und den passenden Weg finden, können Sie die Wissensdatenbank für Ihr Unternehmen besprechen.
- Fragenliste: zehn bis zwanzig echte Fragen aus dem Alltag sammeln.
- Quellen: zu jeder Frage das verbindliche Dokument und seine Verantwortlichen benennen.
- Freigaben: Ordnerrechte prüfen und zu weit gefasste Zugriffe vorher schließen.
- Datenschutz: Datenschutzbeauftragte früh einbinden, Bedarf an Folgenabschätzung prüfen.
- Betriebsrat: bei Mitbestimmung rechtzeitig informieren und Regeln gemeinsam festlegen.
- Pilot: eine Abteilung, ein Zeitraum, klare Testfragen und ein Termin zur Auswertung.
Häufige Fragen
Was ist eine Wissensdatenbank?
Eine Wissensdatenbank ist eine zentrale Sammlung von Wissen eines Unternehmens, etwa Anleitungen, Richtlinien und Antworten auf häufige Fragen. Mit KI kann sie Fragen in natürlicher Sprache beantworten und dabei auf die Fundstellen in den eigenen Dokumenten verweisen.
Wie lange dauert es, eine Wissensdatenbank aufzubauen?
Das hängt vor allem von Menge und Zustand der Dokumente ab, weniger von der Technik. Ein Pilot mit einer Abteilung und gut gepflegten Unterlagen ist deutlich schneller umgesetzt als eine Wissensdatenbank für alle Bereiche mit gescannten Altbeständen.
Brauche ich für eine KI-Wissensdatenbank Fine-Tuning?
Meist nicht. Bei RAG bleibt das Sprachmodell unverändert, das Wissen kommt bei jeder Frage aus Ihren Dokumenten. Laut DSK lässt sich dieses Wissen deshalb einfacher aktualisieren und löschen als Wissen, das in einem Modell steckt. Wann Fine-Tuning trotzdem hilft, erklärt die Seite zum Fine-Tuning.
Welche Dokumente eignen sich nicht?
Ungeeignet sind Entwürfe, veraltete Fassungen, Dokumente aus unklaren Quellen und Inhalte, deren Lizenz eine Verarbeitung ausschließt. Personenbezogene Daten gehören nur hinein, wenn die Antworten sie wirklich brauchen.
Ist eine Datenschutz-Folgenabschätzung Pflicht?
Nach Art. 35 Abs. 1 DSGVO ist sie nötig, wenn eine Verarbeitung voraussichtlich ein hohes Risiko für die Rechte und Freiheiten von Personen hat. Die DSK schreibt, dass dies beim Einsatz von KI-Anwendungen vielfach der Fall sein wird. Ob es für Ihr System zutrifft, ergibt die Vorabprüfung im Einzelfall.
Kann eine KI-Wissensdatenbank Zugriffsrechte beachten?
Ja, wenn die Rechte vor dem Sprachmodell geprüft werden. Die DSK nennt dafür ein Rechte- und Rollenkonzept für Vektordatenbank und Dokumente. Microsoft 365 Copilot zeigt laut Microsoft nur Inhalte an, die eine Person mindestens lesen darf.
Kann ich eine Wissensdatenbank ohne Cloud betreiben?
Ja. Mit Werkzeugen wie Ollama und Open WebUI laufen Sprachmodell, Datenbank und Oberfläche auf eigener Hardware. Laut Ollama sieht der Anbieter bei lokaler Nutzung weder Eingaben noch Daten. Die Anleitung steht auf der Seite zur lokalen KI.
Wer pflegt die Wissensdatenbank im Betrieb?
Bewährt hat sich eine verantwortliche Person je Fachbereich, die Dokumente freigibt, ersetzt und löscht. Die DSK verlangt, regelmäßig zu prüfen, ob die verwendeten Dokumente aktuell und vollständig sind.
Quellen
- Orientierungshilfe zu datenschutzrechtlichen Besonderheiten generativer KI-Systeme mit RAG-Methode, Version 1.0 (Oktober 2025), Datenschutzkonferenz (DSK)
- Orientierungshilfe Künstliche Intelligenz und Datenschutz, Version 1.0 (6. Mai 2024), Datenschutzkonferenz (DSK)
- Datenschutz-Grundverordnung, Textausgabe 2025, Artikel 28 und 35, Berliner Beauftragte für Datenschutz und Informationsfreiheit
- Retrieval-Augmented Generation for Knowledge-Intensive NLP Tasks (Lewis et al., 2020), arXiv
- Daten, Datenschutz und Sicherheit für Microsoft 365 Copilot, Microsoft Learn
- Knowledge Bases and Document Chat, Open WebUI
- Retrieval Augmented Generation (RAG): Changing the Embedding Model, Open WebUI
- FAQ: Does Ollama send my prompts and answers back to ollama.com?, Ollama